笨方法学 Java -31-综合练习2-实现分析-docx 文本替换(续)
这篇文章,讨论的是关于 docx 文件中的处理优化。
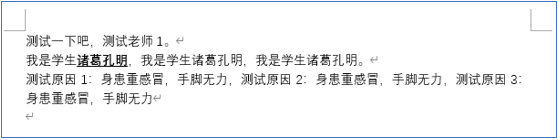
我们知道,XWPF 模块是按照段落中,字符串的属性来区分的。那么如果一段很长的同样式内容,会怎么拆分呢?这个可以看下图:
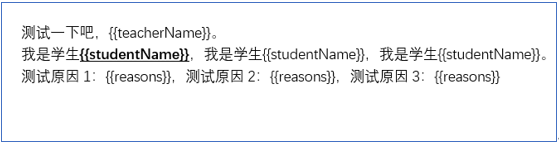
上图中,studentName 变量出现了3次,并且只有第一个添加了 下划线 和 粗体。我们看看程序的解析结果:
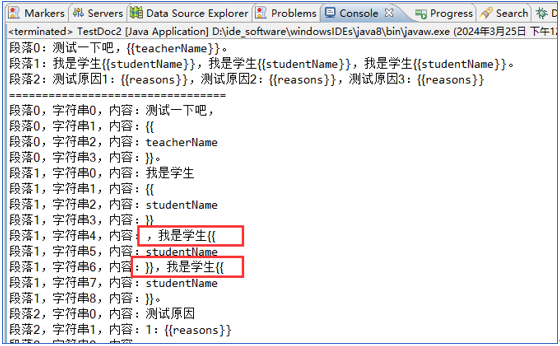
我们可以看到,第2个第3个 studentName 变量,拆分出了前缀“{{”和 “}}”后缀出现在同一行的情况。所以,在上一篇的文章《笨方法学 Java -30-综合练习2-实现分析-docx 文本替换》中,的解析方法,对于这种情况,可能出现解析出错,匹配不到位的问题。
那么,我们应该怎样处理呢?本人觉得,其实区分一下,字符串出现的可能性,再处理字符串的合并即可。根据归纳整理,可能的类型有以下几种:
1、开,...{{...
2、开...闭,...{{...}}...
3、开...闭...开,...{{...}}...{{...
4、闭,...}}...
5、闭...开,...}}...{{...
6、闭...开...闭,...}}...{{...}}...
7、无开闭信息, ...
8、其它无法识别的类型。
在字符串识别上,我们可以使用正则表达式。测试程序如下:
public static void main(String[] args) {
    //开 1
    String s0 = "{{";
    String s00= "塑料袋封口就是{{";
    String s01= "{{student1";
    String s1 = "塑料袋封口就是{{student1";
    //开...闭 2
    String s2 = "是独立访客时间{{student2}}灯笼裤{{student3}}飞机";
    String s20 = "{{student2}}{{student3}}";
    //开...闭...开 3
    String s3 = "是独立访客访客{{student4}}时间裤{{student5}}灯笼裤飞机{{student6";
    String s30 = "是独立访客访客{{student4}}时间裤{{student5}}灯笼裤飞机{{";
    //闭 4
    String s40 = "}}";
    String s4 = "student7}}飞机反馈就";
    //闭...开 5
    String s5 = "student8}}飞机反馈就{{student9";
    String s50 = "student8}}飞机反访客{{student00}}时间访客{{student01}}时间馈就{{student9";
    String s51 = "student8}}飞机反访客时间馈就{{student9";
    //闭...开...闭 6
    String s6 = "student10}}飞机反馈就{{student11}}打开{{student12}}的法律纠纷";
    //无 7
    String s7 = "斯洛伐克江东父老";

    String[] arr = new String[] {s0,s00,s01, s1, s2, s20, s3,s30, s40, s4, s5,s50,s51, s6, s7};

    for(String s : arr) {
        System.out.println(String.format("结果:%s, 字符串:%s",
                                         MyWordUtil.identifyTypeInfoFromText(s), s));
    }
}
执行的结果如下:
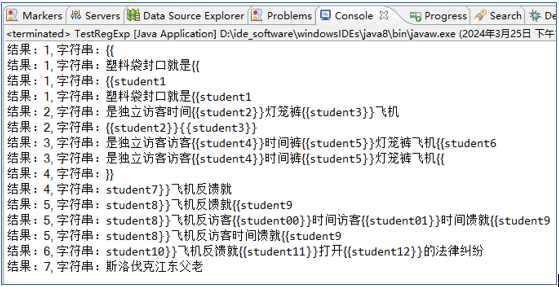
这样我们就可以根据 不同的 字符串 情况,来编写关于 字符串合并的处理。关于正则校验的处理,如下:
/**
* >> 根据传入的字符串信息,识别出该信息符合哪种识别类型。<br/>
* 在参数识别上,如果字符串带有开始符“{{”,或者结束符“}}”,<strong>要么不带参数名,要么必带参数名。</strong><br/>
* 参数名,是一个有数字和字母组合的内容。
* 根据归纳整理,可能的类型有以下几种:<br/>
* 1、开,...{{...<br/>
* 2、开...闭,...{{...}}...<br/>
* 3、开...闭...开,...{{...}}...{{...<br/>
* 4、闭,...}}...<br/>
* 5、闭...开,...}}...{{...<br/>
* 6、闭...开...闭,...}}...{{...}}...<br/>
* 7、无开闭信息, ...<br/>
* 8、其它无法识别的类型。<br/>
* @param oriText 原始的文本
* @return 整数的类型信息。如果参数为 null ,则返回 -1 。
*/
public static int identifyTypeInfoFromText(String oriText) {
int result = -1;
//正则:变量名
String regexpParamName = "[0-9a-zA-Z]+";
//正则:可能有变量名的前缀字符串
String regexpParamWithPre = PARAM_PRE_REGEXP+"("+regexpParamName+")?";
//正则:可能有变量名的后缀字符串
String regexpParamWithSuf = "("+regexpParamName+")?"+PARAM_SUF_REGEXP;
//正则:带前缀、后缀的变量名
String regexpParam = PARAM_PRE_REGEXP+regexpParamName+PARAM_SUF_REGEXP;
//正则:没有前缀字符的可能字符串
String regexpNoBegin = "((?!"+PARAM_PRE_REGEXP+").)*";
//正则:没有后缀字符的可能字符串
String regexpNoEnd = "((?!"+PARAM_SUF_REGEXP+").)*";
//正则:没有前缀、后缀字符的字符串
String regexpNoBeginEnd="((?!("+PARAM_SUF_REGEXP+"|"+PARAM_PRE_REGEXP+")).)*";
/**
* 以下是7种可能的字符串,所对应的正则
*/
String regexp1 = regexpNoEnd+regexpParamWithPre; //只有 开 符号的正则
String regexp2 = "("+regexpNoBeginEnd+regexpParam+regexpNoBeginEnd+")+"; //开...闭 的正则
String regexp3 = "("+regexpNoBeginEnd+regexpParam+regexpNoBeginEnd+")+"+regexpParamWithPre; //开...闭...开 的正则
String regexp4 = regexpParamWithSuf+regexpNoBegin; //只有 闭 符号的正则
String regexp5 = regexpParamWithSuf+".*"+regexpParamWithPre; //闭...开 的正则
String regexp6 = regexpParamWithSuf+"("+regexpNoBeginEnd+regexpParam+regexpNoBeginEnd+")+"; //闭...开...闭
String regexp7 = regexpNoBeginEnd; // 无
if(oriText!=null) {
if(Pattern.matches(regexp1, oriText)) {
result= 1;
}else if(Pattern.matches(regexp2, oriText)) {
result= 2;
}else if(Pattern.matches(regexp3, oriText)) {
result= 3;
}else if(Pattern.matches(regexp4, oriText)) {
result= 4;
}else if(Pattern.matches(regexp5, oriText)) {
result= 5;
}else if(Pattern.matches(regexp6, oriText)) {
result= 6;
}else if(Pattern.matches(regexp7, oriText)) {
result= 7;
}else {
result= 8;
}
}
return result;
}接下来,我们处理字符串合并。字符串合并,在原有的 getRunInfoFromParagrah 方法上修改。处理如下:
/**
 * >> 在处理 office word 文档中,docx 类型的文档时,
 * 由于字符处理时,需要替换的变量字符串可能分割在几个对象中,需要合并
 * @param paragrah 段落对象
 * @return List<XWPFRun>
 */
public static List<XWPFRun> getRunInfoFromParagrah(XWPFParagraph paragrah){
    //结果对象
    List<XWPFRun> result = null;
    //参数正常才开始处理
    if(paragrah!=null && paragrah.getRuns()!=null && paragrah.getRuns().size()>0) {
        //结果初始化
        result = paragrah.getRuns();
        //装载合并字符串的容器
        StringBuffer buffer = new StringBuffer();
        //合并字符串时,接收字符串的变量
        XWPFRun targetRun = null;
        //是否合并的标识
        boolean needAppend = false;
        //循环遍历,将字符串合并
        for(int i=0;i<result.size();i++) {
            XWPFRun tmp = result.get(i);
            //根据字符串内容,识别成对应的类型序号
            //根据 type 类型,处理字符串
            int type = identifyTypeInfoFromText(tmp.text());
            if(type==1) { // 1、开,...{{...
                targetRun = tmp;
                buffer.append(tmp.text());
                needAppend = true;
            }else if(type==2) { // 2、开...闭,...{{...}}...
                if(needAppend) {
                    buffer.append(tmp.text());
                    paragrah.removeRun(i);
                    paragrah.insertNewRun(i);
                }else {
                    continue;
                }
            }else if(type==3) { // 3、开...闭...开,...{{...}}...{{...
                targetRun = tmp;
                buffer.append(tmp.text());
                needAppend = true;
            }else if(type==4) { // 4、闭,...}}...
                buffer.append(tmp.text());
                paragrah.removeRun(i);
                paragrah.insertNewRun(i);//==删掉之后数组的序号就变了,需要插一个空的进去
                //将变量全部字符串合并到target
                targetRun.setText(buffer.toString(), 0);
                //清零
                buffer.setLength(0);
                targetRun = null;
                needAppend=false;
            }else if(type==5) { // 5、闭...开,...}}...{{...
                if(needAppend) {
                    buffer.append(tmp.text());
                    paragrah.removeRun(i);
                    paragrah.insertNewRun(i);
                }else {
                    continue;
                }
            }else if(type==6) { // 6、闭...开...闭,...}}...{{...}}...
                buffer.append(tmp.text());
                paragrah.removeRun(i);
                paragrah.insertNewRun(i);//==删掉之后数组的序号就变了,需要插一个空的进去
                //将变量全部字符串合并到target
                targetRun.setText(buffer.toString(), 0);
                //清零
                buffer.setLength(0);
                targetRun = null;
                needAppend=false;
            }else if(type==7 || type==8 || type==-1) {
                // 7、无开闭信息, ...  8、其它无法识别的类型。 -1、字符串为 null 。参数异常
                if(needAppend) {
                    buffer.append(tmp==null?"":tmp.text());
                    paragrah.removeRun(i);
                    paragrah.insertNewRun(i);//删掉之后序号就变了,需要插一个空
                }else {
                    continue;
                }
            }
        }
    }
    return result;
}
接下来,我们看下,改进后的处理程序,能识别出来什么:
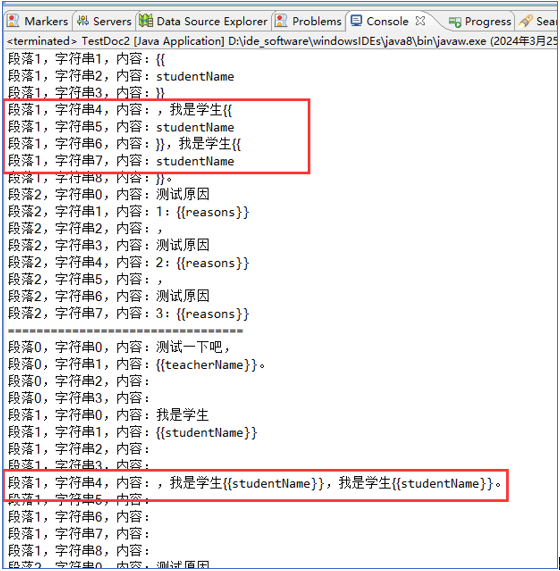
这样,我们就把零散的 字符串 成功合并了,接下来,只需要 执行内容替换即可。
替换后的结果如下:
本章完结