1、简要说明
在工具包中,与其说这是文件读写;还不如说,这其实是字符串的读写。因为,在我 pdc-common-tool 提供的API中没有二进制内容的读写。那么大家现在应该对文件读写有个了解了吧。因为是字符串的读写,所以会涉及几个问题:字符内容如何读写?字符编码如何处理?下面我们一步步分开解析。
2、文件读写处理逻辑
在工具类实现上,文件字符的读、写可以参考以下流程图:
2.1 文件写入实现
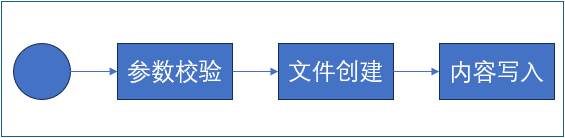
写入时的要点:
l 在校验的时候,除了要验证参数合法性,还要验证文件是否存在。如果文件不存在,那需要创建。
l 在创建文件时,要先递归创建上级文件夹。否则,文件是无法创建的。
l 字符内容写入前,要先判断文件是否可写入。因为文件如果被其它程序占用了,写入时无法写入。
l 最终,字符内容写入时,要使用缓冲池的方式。否则一次性大量写入容易出问题。
l 另外,写入前要明确用什么字符集来写入。这个问题,在第3章节讨论。
2.2 文件读取实现
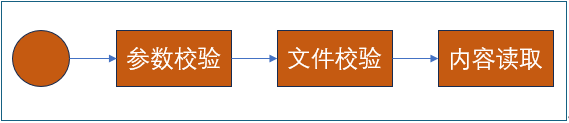
读取时的要点:
l 在校验的时候,除了要验证参数合法性,还要验证文件是否存在。如果文件不存在,那没法读取。
l 字符内容读取前,要先判断文件是否可读取。因为有些情况下,由于权限问题,可能读取不了。
l 最终,字符内容读取时,要使用缓冲池的方式。否则一次性读入大量容易出问题。
l 另外,读取前要明确用什么字符集来读取。这个问题,在第3章节讨论。
3、关于字符集
在计算机中,字符集就是它能表示的字符的一个集合。其实,计算机中的字符处理,一直是一个难题。因为,在这世界上,不同国家有不同文字和符号。比如:英语中字母+符号 不超过 128个字符;而中文,文字+符号 有好几万个;如果算上一些新出现的emoji表情包,那就更多了。在 Java 语言中,内置的编码是 Unicode 编码。
计算机技术在不断推广的过程中,因为需要兼容不同的国家文字和符号,所以诞生了很多不同的字符集。目前,中国国内使用的主要的字符集有以下几个:ISO-8859-1、GB2312、BIG5、GBK、UTF-8、GB18030。下面简单的介绍下这几个字符集的情况:
l ISO-8859-1 编码是单字节编码,向下兼容ASCII,其编码范围是0x00-0xFF,0x00-0x7F之间完全和ASCII一致,0x80-0x9F之间是控制字符,0xA0-0xFF之间是文字符号
l GB 2312 编码是双字节编码,标准共收录6763个汉字,其中一级汉字3755个,二级汉字3008个;同时,GB 2312收录了包括拉丁字母、希腊字母、日文平假名及片假名字母、俄语西里尔字母在内的682个全角字符。
l Big5,又称为大五码或五大码,编码是双字节编码。它是使用繁体中文(正体中文)社区中最常用的电脑汉字字符集标准,共收录13,060个汉字。
l GBK 向下与 GB 2312 编码兼容,向上支持 ISO 10646.1国际标准,是前者向后者过渡过程中的一个承上启下的产物。GBK编码,是在GB2312-80标准基础上的内码扩展规范,使用了双字节编码方案,其编码范围从8140至FEFE(剔除xx7F),共23940个码位,共收录了21003个汉字,完全兼容GB2312-80标准,支持国际标准ISO/IEC10646-1和国家标准GB13000-1中的全部中日韩汉字,并包含了BIG5编码中的所有汉字。2000年已被GB18030-2000《信息交换用 汉字编码字符集 基本集的扩充》国家强制标准替代
l GB 18030 完全兼容GBK、GB2312,并且是后二者的替代标准,也将是今后唯一的字符集国家标准。该标准分为两个部分:双字节部分和四字节部分。双字节部分和GBK基本完全相同。四字节部分,比GBK多了6582个汉字(27484-20902),0x8139ef30~0x82358738。对应GB13000.1则为0x3400~0x4db5。
l UTF-8 是针对Unicode的一种可变长度字符编码。它可以用来表示Unicode标准中的任何字符,而且其编码中的第一个字节仍与ASCII相容,使得原来处理ASCII字符的软件无需或只进行少部分修改后,便可继续使用。它可以使用1~4个字节表示一个符号,根据不同的符号而变化字节长度。
(1) 128 个 ASCII 字符(Unicode 范围由 U+0000 至 U+007F)只需一个字节;
(2) 带有变音符号的拉丁文、希腊文、西里尔字母、亚美尼亚语、希伯来文、阿拉伯文、叙利亚文及马尔代夫语(Unicode 范围由 U+0080 至 U+07FF)需要二个字节;
(3) 其他基本多文种平面(BMP)中的字符(CJK属于此类-Qieqie注)使用三个字节;(中文属于此类)
(4) 其他 Unicode 辅助平面的字符使用四字节编码
4、关于字符识别
现在,大家了解了各种字符集的情况了。这里,我们讨论下,关于字符识别的问题。这主要问题是不同编码使用的字节长度问题。
比如:当我们以UTF-8编码保存了一些中文字符,它是以3字节一个字符的形式储存的;但是,我们用GBK编码将保存的字符读取,它读取时按照2字节长度读取。这时,就产生了一个问题:少读取了1个字节。少了1个字节,内容就无法正常显示了。这也是众多字符乱码的根源。
因此,我们在计算机保存和读取文件时,必须知道文件是以什么字符集保存,才能正确读取出文字和符号。
5、工具类FileUtil使用
通过上面几个章节的描述,大家对于计算机系统读、写字符文件的操作应该有个全面的了解了吧。现在,我们选几个常用的 API 进行讲解。详细的API描述,可以参考 Javadoc 文件中的说明。
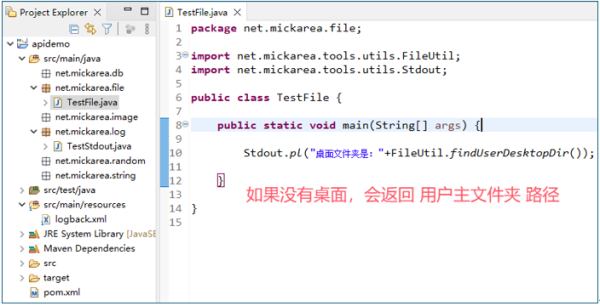
5.1 获取桌面目录路径
这个获取路径的函数,主要用于测试用。因为文件生成后在桌面,比较容易找到。调用代码如下图:
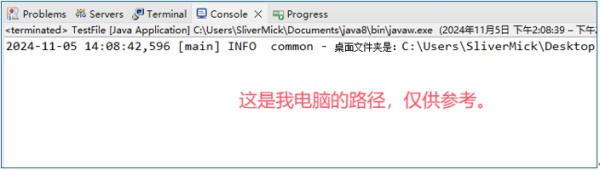
调用结果:
5.2 将字符串保存到本地文件
在保存内容到本地文件时,可以选择是 以覆盖的形式,还是 以追加的形式。默认是覆盖,如果要以追加形式保存,需要指定 isAppend 参数 为true。这里我们使用 BIG5 字符集(如果调用的函数没有字符集参数,默认是UTF-8字符集)保存一段内容,看看:
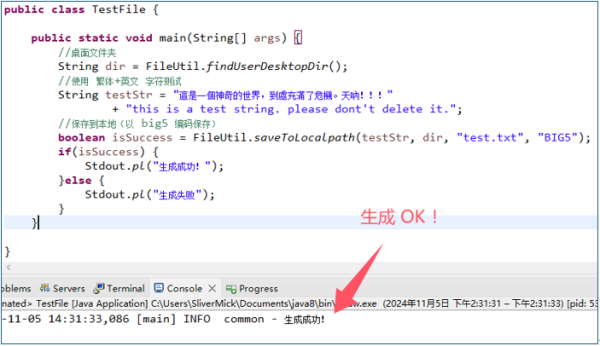
生成文件,打开如下:
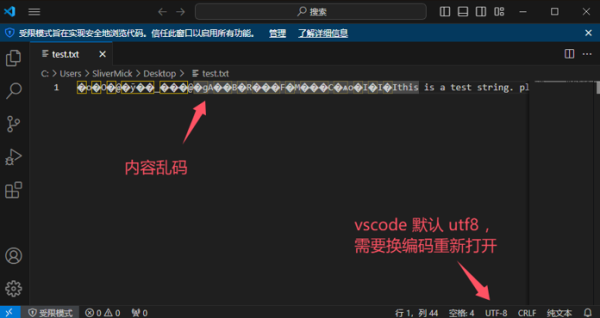
选择字符集,重新打开如下:
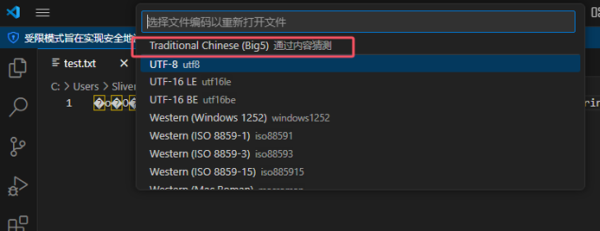
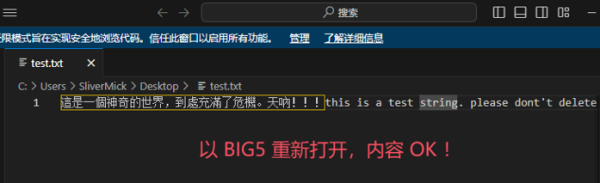
5.3 从本地文件读取字符串信息
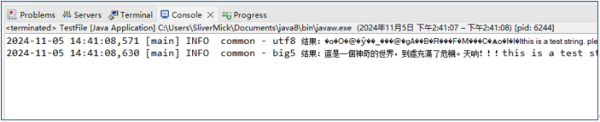
从本地文件读取字符内容,需要指定字符集。如果不指定字符集,工具包将以 UTF-8 字符集读取。具体看下面的示例代码:
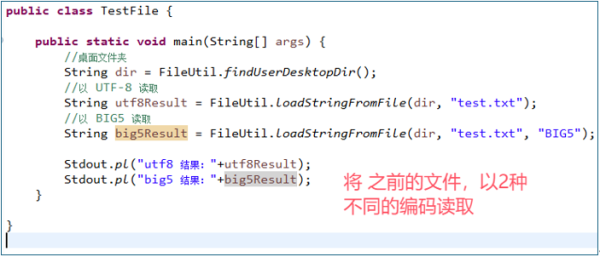
读取的结果如下:
本章完结