1、简要说明
在考虑开发一个博客网站之初,我就考虑到一个问题:如何生成文章的SEO关键字信息。因为,因为文章数量还是挺多的,如果我每次都自己编辑那就太麻烦了。这里我取一篇文章的html内容举例:
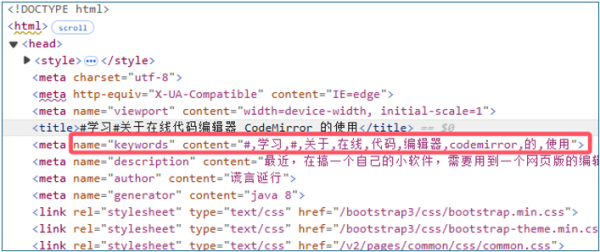
通过上图可以看出,关键字是根据标题拆分的。如果每次都是我来拆分,那这工作量还是挺大的。因此,我考虑找一些工具来处理。经过一番查找,找到了“Ansj中文分词”。有了它,我就可以专心负责文章的编写。在文章保存时,调用“Ansj中文分词”来自动生成SEO关键字信息。
2、实现原理
“Ansj中文分词”,是一个基于n-Gram+CRF+HMM的中文分词的java实现。分词速度达到每秒钟大约200万字左右(mac air下测试),准确率能达到96%以上。目前实现了中文分词、中文姓名识别、用户自定义词典、关键字提取、自动摘要、关键字标记等功能,可以应用到自然语言处理等方面,适用于对分词效果要求高的各种项目。
源码库地址:https://github.com/NLPchina/ansj_seg
使用说明文档:https://github.com/NLPchina/ansj_seg/wiki
2.1、分词方式
在Ansj中,有5种分词方式,简单介绍如下:
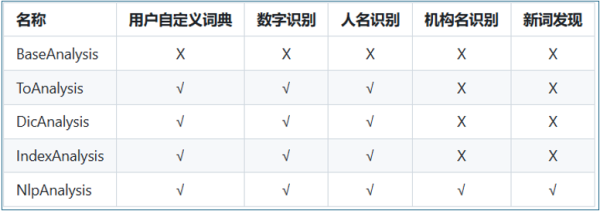
BaseAnalysis 最小颗粒度的分词。基本就是保证了最基本的分词.词语颗粒度最非常小的。所涉及到的词大约是10万左右。基本分词速度非常快.在macAir上.能到每秒300w字每秒。同时准确率也很高.但是对于新词他的功能十分有限。
ToAnalysis 精准分词。它在易用性,稳定性.准确性.以及分词效率上.都取得了一个不错的平衡.如果你初次尝试Ansj如果你想开箱即用.那么就用这个分词方式是不会错的。
DicAnalysis 用户自定义词典优先策略的分词。用户自定义词典优先策略的分词,如果你的用户自定义词典足够好,或者你的需求对用户自定义词典的要求比较高,那么强烈建议你使用DicAnalysis的分词方式。可以说在很多方面Dic优于ToAnalysis的结果。
IndexAnalysis 面向索引的分词。面向索引的分词。顾名思义就是适合在lucene等文本检索中用到的分词。 主要考虑以下两点。
(1)召回率 * 召回率是对分词结果尽可能的涵盖。比如对“上海虹桥机场南路” 召回结果是[上海/ns, 上海虹桥机场/nt, 虹桥/ns, 虹桥机场/nz, 机场/n, 南路/nr]
(2)准确率 * 其实这和召回本身是具有一定矛盾性的Ansj的强大之处是很巧妙的避开了这两个的冲突 。比如我们常见的歧义句“旅游和服务”->对于一般保证召回 。大家会给出的结果是“旅游 和服 服务” 对于ansj不存在跨term的分词。意思就是。召回的词只是针对精准分词之后的结果的一个细分。比较好的解决了这个问题。
NlpAnalysis 带有新词发现功能的分词。nlp分词是总能给你惊喜的一种分词方式。它可以识别出未登录词。但是它也有它的缺点:速度比较慢,稳定性差。分词速度大约40w字每秒。nlp的适用方式,语法实体名抽取,未登录词整理,主要是对文本进行发现分析等工作。
2.2、分词优劣对比
对于这几种分词方式,大家可以通过这个表格,简单了解下它们的不同。
3、API调用举例
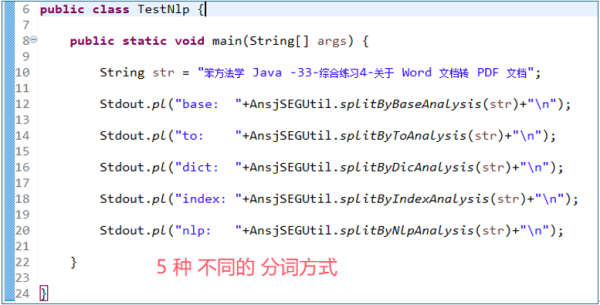
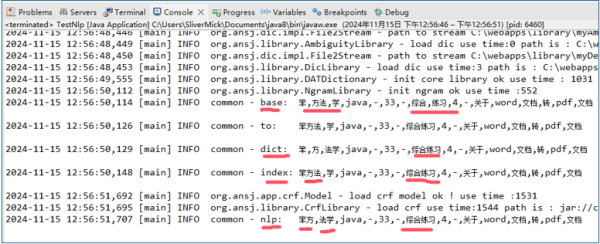
通过上面的信息,大家应该对分词处理有个大概的印象了。这里我简单给大家演示一下几个分词方式的处理方式:
3.1、创建配置文件
这里我贴出自己的配置文件,大家可以参考一下。library.properties文件要注意放到指定位置。
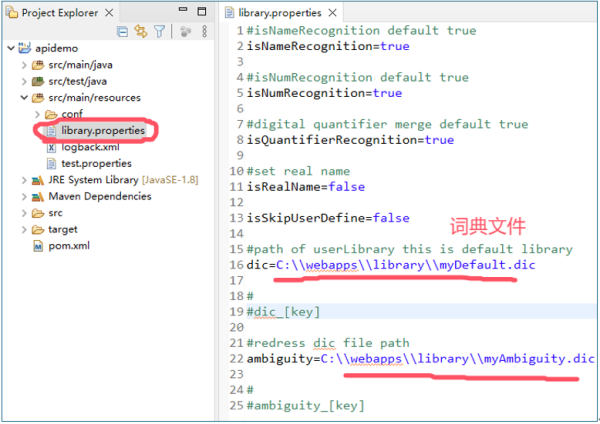
具体的配置说明,参考:
https://github.com/NLPchina/ansj_seg/wiki/配置文件说明
用户自定义词典说明:参考:
https://github.com/NLPchina/ansj_seg/wiki/用户自定义词典
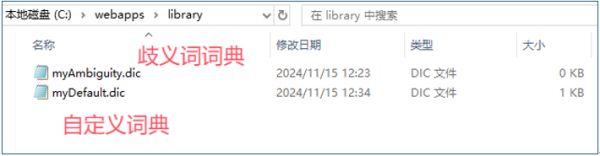
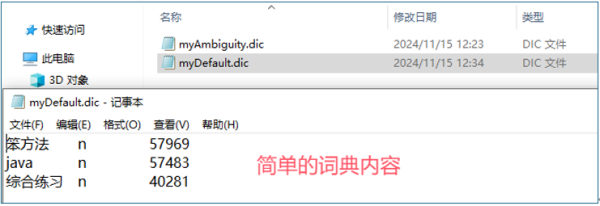
3.2、创建词典文件
3.3、调用举例
本章节结束